预测性维护怎么落地:先判断哪些设备值得做
预测性维护需要的不只是传感器和算法,还包括可识别的故障模式、可靠数据、现场验证能力与明确的处置流程。建筑运维团队应先判断设备重要性和干预条件,再选择合适的试点。本文讨论适用边界、误报成本与分阶段验证方法。
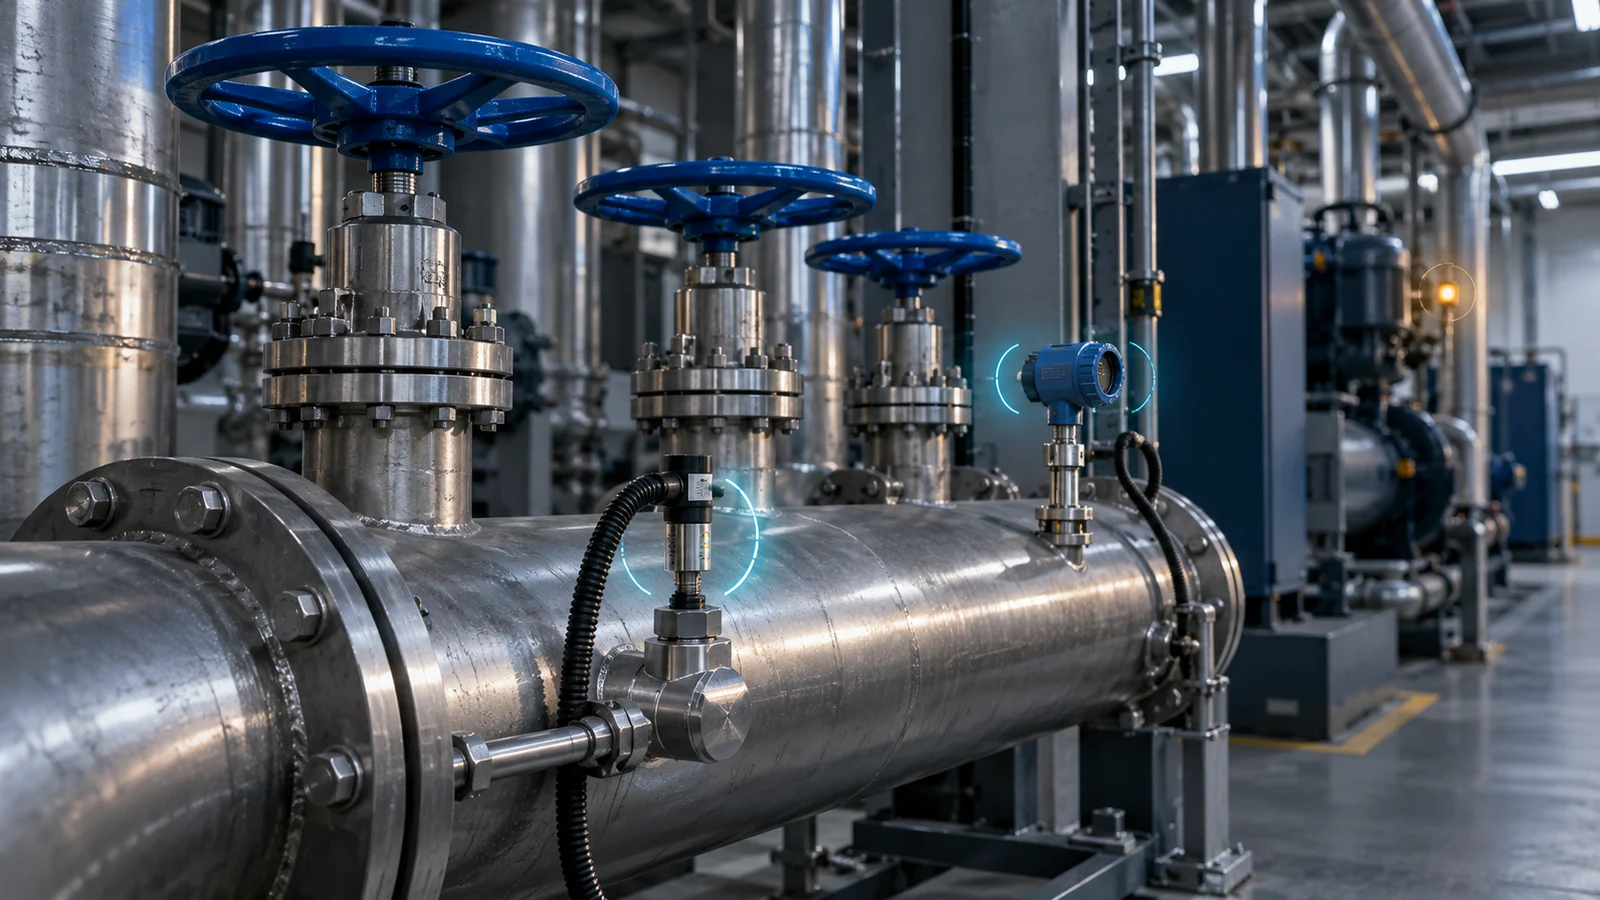
把设备运行数据接入平台,只是预测性维护的准备工作。真正需要回答的是:某种异常是否能够提前识别,提前识别后能否采取有效行动,以及这样做是否比现有维护方式更合适。
美国能源部的运维资料区分了纠正性、预防性、预测性以及以可靠性为中心的维护方法。可以从中借鉴的原则是,根据设备作用和运行条件组合安排维护,而不是要求所有设备采用同一种方式。参考:DOE 运维方法
先区分三个容易混淆的目标
状态监测回答“现在测到了什么”,例如温度、振动或运行电流。异常检测回答“当前表现是否偏离已定义的正常条件”。故障预测则试图判断未来的故障风险或剩余可用时间,所需证据与验证难度不同。
一条越限报警不宜直接命名为预测性维护。它可能具有实际价值,但应准确说明依据、适用范围和局限。把功能名称写得比能力更强,会使一线人员对提示产生错误期待。
同样,趋势图上的连续变化也未必代表设备劣化。负荷、环境和运行模式变化都可能造成趋势差异。试点方案应说明哪些条件被纳入分析,哪些情况需要人工判断。
选择具有行动价值的设备
筛选试点时,可以先讨论设备服务影响、历史问题、可采集信号以及现场干预条件。如果即使提前获得提示,也没有检查手段、备件或合适的停机窗口,分析价值就很难兑现。
| 筛选问题 | 适合继续推进的证据 |
|---|---|
| 需要防范什么问题 | 明确的故障模式及其实际影响 |
| 是否存在可观察信号 | 可稳定采集、能够解释的状态变化 |
| 如何确认提示是否正确 | 有现场检查、维修或专业检测记录 |
| 提前提示后做什么 | 明确的负责人、检查任务与处理窗口 |
| 结果怎样评价 | 事先约定的误报、漏报和工作量统计 |
对低影响、易替换且缺乏有效监测信号的设备,增加复杂分析未必合理。对重要设备,也不能因为采用了预测分析,就自动取消适用的法定检查、厂家要求或已批准的维护计划。
数据准备从可靠性开始
需要检查传感器校验、采样间隔、时间戳、单位、缺失值和设备身份。设备更换或传感器位置调整后,历史数据的解释条件可能发生变化,应保留相应事件记录。
故障标签同样重要。“已维修”不能充分说明出现了哪种问题、采取了什么措施、最终如何验证。可以先改善工单结果记录,让实际检查发现与设备趋势能够对应,再讨论更复杂的模型训练。
如果历史故障样本有限,应明确分析能够支持到什么程度。小样本下的试点结果不能直接宣传为适用于全部设备类型,实验室或其他场景中的效果也不能直接当作本项目收益。
先旁路观察,再参与工作安排
建议先让分析提示以观察方式运行,由专业人员复核,不直接触发设备控制。每条提示记录发生时间、依据、复核发现以及最终采取的动作,逐步形成可解释的样本。
评估时既要统计提示命中的问题,也要检查没有被提示却实际发生的问题。仅看已提示事件的准确率,可能遗漏未被识别的故障。还应记录工程人员为核查提示付出的时间,判断新增工作量是否合理。
误报成本与漏报影响由设备场景决定。调整阈值时,应由负责人员评审并保留版本与原因,避免为减少看板上的报警数量而不断放宽条件。
将结果接入工单,而不是停在看板
有效的提示需要明确接收人、响应规则和升级路径。工单中应能看到提示依据、近期趋势以及相关设备资料,现场处理结束后再补充复核结果,形成反馈。
对于数据异常、传感器故障和真实设备问题,应分别记录。否则把传感器断线当作设备失效处理,不仅消耗资源,也会污染后续分析数据。
还要为分析不可用的情况安排明确处理方式。采集链路中断或必要数据失效时,应标记当前分析依据不足,并提醒责任人检查数据来源。系统没有产生提示,不能直接解释为设备正常。日常维护任务是否继续、如何采用既有工作程序,应在试点开始前由管理团队确认。
试点扩大前,应检查规则在不同负荷、季节和班组条件下的表现,并确定持续维护责任。预测性维护是一项长期运行的工作安排,算法只是其中一部分。若尚未具备稳定点位与资产映射,可先完成BIM 与 IoT 数据质量检查。